요즘 AI 서비스를 쓰다 보면 모델을 고르는 칸에 '생각하기'나 '추론' 같은 선택지가 붙어 있는 경우가 많습니다. 이 옵션을 켜면 AI가 답을 내놓기 전에 한참 동안 스스로 풀이 과정을 적어 내려가고, 그만큼 답이 늦게 나옵니다. 그래서 자연스럽게 이런 생각이 듭니다. 오래 생각하는 쪽이 당연히 더 정확하지 않을까? 기다리는 시간이 조금 아깝더라도 웬만하면 추론 모델을 쓰는 게 낫지 않을까?

2025년 6월, 애플 연구진이 이 질문에 정면으로 답한 논문을 논문 공개 사이트 아카이브(arXiv)에 올렸습니다. 제목은 '생각의 환상(The Illusion of Thinking)'이고, 같은 해 11월에는 수정본이 나와 인공지능 학회 뉴립스(NeurIPS) 2025에 실렸습니다. 결론부터 말하면, 추론 모델이 언제나 나은 것은 아니었습니다. 문제가 얼마나 복잡한지에 따라 일반 모델이 앞서는 구간, 추론 모델이 앞서는 구간, 그리고 둘 다 무너지는 구간이 따로 있었다는 것입니다. 이 글에서는 연구진이 어떻게 실험했는지, 세 구간은 각각 어떤 모습이었는지, 그리고 이 결과를 어디까지 받아들여야 하는지 차례로 살펴보겠습니다.
추론 모델은 무엇이 다를까요?
먼저 용어부터 정리해 보겠습니다. 우리가 흔히 쓰는 대화형 AI는 대규모 언어 모델(LLM, Large Language Model)입니다. 질문을 받으면 곧바로 답을 이어 써 내려가죠. 논문은 이것을 '일반 모델'이라고 부릅니다. 반면 대규모 추론 모델(LRM, Large Reasoning Model)은 답을 내기 전에 긴 사고 과정을 먼저 만들어 냅니다. 문제를 쪼개 보고, 중간에 스스로 검토하고, 틀린 것 같으면 다시 돌아가는 식입니다. 이 과정을 흔히 '생각의 사슬(Chain-of-Thought)'이라고 하며, 강화학습으로 이런 습관을 길러 낸 모델들이 잇따라 등장했습니다.
추론 모델은 수학·코딩 시험에서 좋은 점수를 받으며 주목받았습니다. 그런데 연구진은 이 점수만으로는 알 수 있는 것이 많지 않다고 봤습니다. 이유는 두 가지입니다. 첫째, 널리 쓰이는 수학 시험 문제는 이미 인터넷에 풀이가 퍼져 있어서, 모델이 학습 중에 답을 미리 봤을 가능성(데이터 오염)을 배제하기 어렵습니다. 둘째, 기존 평가는 최종 답이 맞았는지만 볼 뿐, 그 답에 이르기까지 모델이 무엇을 생각했는지는 들여다보지 않습니다.
실제로 연구진이 수학 시험으로 먼저 비교해 보니 결과가 애매했습니다. 두 모델에 같은 연산량을 주었을 때, 비교적 쉬운 수학 문제 모음(MATH-500)에서는 추론 모델과 일반 모델의 성적이 비슷했습니다. 미국 수학 경시대회 문제(AIME)로 가자 격차가 벌어졌는데, 2024년 문제보다 2025년 문제에서 더 크게 벌어졌습니다. 그런데 사람 응시자들은 오히려 2025년 문제를 더 잘 풀었습니다. 사람에게 더 쉬웠던 시험에서 모델 점수가 더 낮았다면, 그 차이가 난이도 때문인지 학습 데이터에 섞여 든 문제 때문인지 가려내기 어렵습니다. 그래서 연구진은 수학 시험 대신 퍼즐을 꺼내 들었습니다.
하노이의 탑으로 난이도를 조절하다
연구진이 쓴 퍼즐은 네 가지입니다. 대표적인 것이 하노이의 탑입니다. 기둥 세 개와 크기가 다른 원판 여러 개가 있고, 첫 번째 기둥에 쌓인 원판을 세 번째 기둥으로 모두 옮기면 됩니다. 규칙은 간단합니다. 한 번에 한 개씩, 맨 위의 원판만 옮길 수 있고, 큰 원판을 작은 원판 위에 올려서는 안 됩니다. 원판이 n개면 최소 2ⁿ−1번을 움직여야 하므로, 원판을 하나 늘릴 때마다 필요한 이동 횟수가 거의 두 배로 늘어납니다. 원판 3개면 7번이지만, 10개면 1,023번입니다.
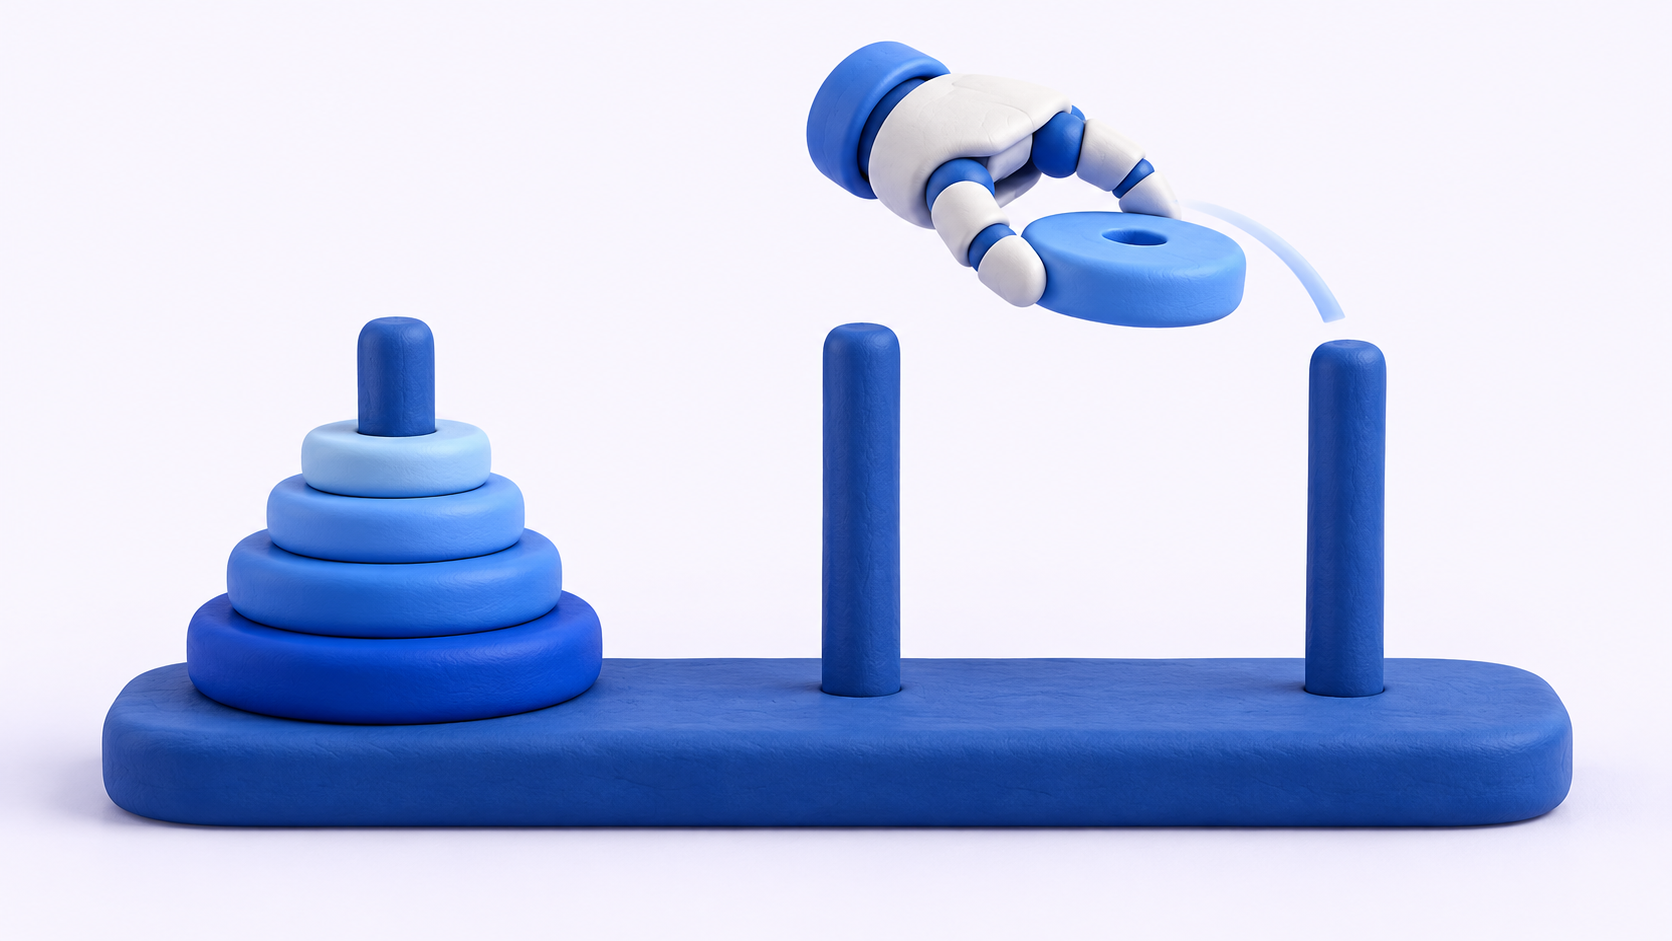
나머지 세 퍼즐도 성격이 비슷합니다. 한 줄로 놓인 빨간 말과 파란 말의 자리를 서로 바꾸는 체커 점프, 정해진 조건을 지키며 여러 사람을 배로 강 건너편에 옮기는 강 건너기, 쌓여 있는 블록을 목표 모양대로 다시 쌓는 블록 쌓기입니다. 네 퍼즐 모두 규칙은 그대로 두고 원판이나 말, 사람, 블록의 수만 늘리면 난이도를 원하는 만큼 조절할 수 있습니다. 또 시뮬레이터로 한 수 한 수가 규칙에 맞는지 바로 확인할 수 있어서, 최종 답뿐 아니라 모델이 생각하는 도중에 내놓은 중간 풀이까지 채점할 수 있습니다. 새로 만든 문제이니 학습 데이터에 섞여 있을 걱정도 줄어듭니다.
비교 방식도 눈여겨볼 만합니다. 연구진은 같은 계열의 추론 모델과 일반 모델을 짝지어, 두 모델에 같은 양의 추론 연산을 주고 성적을 겨루게 했습니다. 추론 모델은 생각하는 데 토큰을 많이 쓰니, 일반 모델에도 같은 예산 안에서 여러 번 답을 시도할 기회를 준 셈입니다. 실험에 쓰인 것은 2025년 상반기에 나와 있던 모델들입니다.
문제 난이도에 따라 갈린 세 구간
결과는 세 구간으로 뚜렷하게 나뉘었습니다.
첫 번째는 쉬운 구간입니다. 원판이 몇 개 안 되는 하노이의 탑처럼 단계가 짧은 문제에서는 일반 모델이 추론 모델보다 정확했고, 토큰도 훨씬 적게 썼습니다. 연구진도 이 결과를 두고 "놀랍게도"라는 표현을 썼습니다. 사고 과정을 들여다보니 이유가 보였습니다. 추론 모델은 쉬운 문제에서 정답을 일찍 찾아 놓고도 계속 다른 길을 탐색하며 틀린 풀이까지 붙들고 있곤 했습니다. 이른바 '과잉 사고(overthinking)'입니다.
두 번째는 중간 구간입니다. 문제가 적당히 복잡해지자 추론 모델이 앞서기 시작했습니다. 이 구간에서 추론 모델은 틀린 풀이를 여러 번 거친 끝에 정답에 도달하는 경우가 많았습니다. 생각을 더 하는 것이 실제로 도움이 되는 구간이라고 할 수 있습니다.
세 번째는 어려운 구간입니다. 일정 수준을 넘어서자 두 모델 모두 정확도가 0에 가깝게 떨어졌습니다. 연산량을 얼마나 더 주든 마찬가지였습니다. 이때 추론 모델은 초반에 잡은 틀린 풀이에 매달린 채 남은 토큰을 써 버리는 모습을 보였습니다.
어려워질수록 오히려 덜 생각했다
연구진이 가장 직관에 어긋난다고 꼽은 결과는 따로 있습니다. 문제가 어려워질수록 추론 모델이 생각하는 데 쓰는 토큰은 늘어났습니다. 여기까지는 예상대로입니다. 그런데 정확도가 무너지는 지점에 가까워지자, 문제가 더 어려워지는데도 생각하는 양이 오히려 줄어들었습니다. 쓸 수 있는 토큰이 아직 넉넉히 남아 있는 상태였는데도 말입니다.
사람으로 치면 시험 문제가 어려울수록 고민하는 시간이 늘다가, 어느 선을 넘으면 시간이 남았는데도 일찍 답안지를 내는 모습과 비슷합니다. 연구진은 이를 두고, 추론 모델이 문제의 복잡도에 맞춰 생각하는 양을 늘리는 데에 근본적인 한계가 있다고 해석했습니다.
정확한 계산에서의 약점도 드러났습니다. 풀이 알고리즘을 명시적으로 알려 주어도 모델이 그 덕을 제대로 보지 못했고, 문제의 종류와 규모에 따라 추론이 일관되지 않았습니다.
반론도 있습니다
이 논문은 나오자마자 큰 화제가 됐고, 사흘 뒤 반론도 나왔습니다. 앨릭스 로슨(Alex Lawsen)은 같은 아카이브에 올린 짧은 논평에서 정확도 붕괴의 상당 부분이 추론 능력의 한계가 아니라 실험 설계 탓이라고 주장했습니다. 지적은 세 가지입니다. 첫째, 원판이 많은 하노이의 탑은 이동 목록 자체가 너무 길어서 모델이 한 번에 출력할 수 있는 토큰 한도를 넘을 수 있고, 실제로 모델이 답변 중에 그 한도를 언급하기도 했다는 것입니다. 둘째, 자동 채점 방식이 '추론을 못 한 것'과 '출력 길이 제약에 걸린 것'을 구분하지 못한다는 것입니다. 셋째, 강 건너기 퍼즐에서 사람이 여섯 쌍 이상(N>5)인 문제는 배 정원이 부족해 수학적으로 풀 수 없는데도, 이를 못 푼 것을 실패로 셌다는 것입니다. 로슨은 이동 목록을 전부 적게 하는 대신 해답을 만들어 내는 함수를 쓰게 하자, 앞서 완전히 실패했다던 하노이의 탑 문제에서도 높은 정확도가 나왔다는 예비 실험 결과를 덧붙였습니다.
정리하면, 어려운 구간에서 두 모델이 모두 무너졌다는 결과는 추론 능력의 한계를 보여 준 것일 수도 있고, 실험 조건이 만들어 낸 결과일 수도 있습니다. 논문 제목만 보고 "AI는 결국 생각하지 못한다"고 단정하는 것은 원 논문의 주장보다도, 반론까지 포함한 지금의 논의보다도 한참 앞서 나간 해석입니다.
이 결과를 어디까지 받아들여야 할까요?
몇 가지 조건을 기억해 둘 필요가 있습니다. 먼저 이 결과는 퍼즐 환경에서 나온 것입니다. 하노이의 탑이나 강 건너기는 규칙이 분명하고 단계를 정확히 밟아야 하는 문제여서, 보고서 작성이나 아이디어 정리처럼 정답이 하나로 정해지지 않은 업무에 세 구간이 그대로 들어맞는다고 볼 근거는 논문에 없습니다. 다음으로, 세 구간은 두 모델에 같은 연산량을 맞춘 조건에서 잰 결과입니다. 마지막으로 실험에 쓰인 모델은 2025년 상반기 모델들이고, 지금 쓰는 최신 모델에서도 같은 결과가 나온다는 근거는 이 논문에 없습니다.
그럼에도 이 연구가 던지는 메시지는 분명합니다. '생각하는 모델'을 켜는 것이 언제나 정답은 아니라는 점입니다. 간단한 질문에 추론 모드를 켜면 시간과 비용이 더 들 뿐 아니라, 이미 찾은 답을 두고 엉뚱한 길로 빠질 수도 있습니다. 반대로 단계가 여러 개 얽힌 중간 난이도의 문제라면 추론 모델이 제값을 할 가능성이 큽니다. 그리고 아주 복잡한 문제라면 어떤 모델이든 한 번에 통째로 맡기기보다, 문제를 작은 단계로 나눠 주거나 결과를 직접 검산하는 편이 안전합니다. 로슨의 반론에서 보듯, 수천 단계의 답을 줄줄이 적게 하는 대신 답을 만드는 방법을 묻는 것처럼 질문 방식을 바꾸는 것만으로도 결과가 달라질 수 있습니다.
결국 중요한 것은 어떤 모델이 더 똑똑한가보다, 지금 내 앞의 문제가 얼마나 복잡한지 먼저 가늠해 보는 일입니다. 모델 선택 칸 앞에서 잠시 멈춰 '이 문제는 쉬운 쪽일까, 중간일까, 아니면 쪼개서 맡겨야 할 만큼 어려운 쪽일까'를 따져 보는 습관이 AI를 더 잘 쓰는 첫걸음일 것입니다.